上下文并行
The context parallel features include Prefill Context Parallel (PCP) and Decode Context Parallel (DCP).
Prefill Context Parallel splits prefill tokens across additional ranks to reduce time to first token. See the Context Parallel Guide for PCP configuration, supported feature combinations, and constraints.
解码上下文并行在 DCP 组内的各个 rank 之间沿序列维度对 KV cache 进行分片,这些 rank 可以复用 TP rank、PCP rank 或两者。它消除了冗余的 KV cache 存储,而无需向进程 world 中添加设备。
This document describes PCP execution and DCP cache sharding. See the PCP/DCP RFC for the design rationale.
KV缓存布局
DCP 以交错布局在各个 rank 之间存储 token。交错粒度由 cp_kv_cache_interleave_size 控制,其声明的默认值为 1。
SFA+DCP 使用 block_size 作为有效的交错大小;当启用 KV 传输时,请将其显式设置为 block_size,以避免配置错误。
对于大小为dcp_size的DCP,一个虚拟块包含block_size * dcp_size个令牌。对于令牌x:
virtual_block_index = x // (block_size * dcp_size)offset_in_virtual_block = x % (block_size * dcp_size)interleave_index = offset_in_virtual_block // cp_kv_cache_interleave_sizetarget_rank = interleave_index % dcp_size
槽位映射计算使用此布局,因此每个DCP rank仅存储其本地序列分片。当前实现要求block_size % cp_kv_cache_interleave_size == 0。
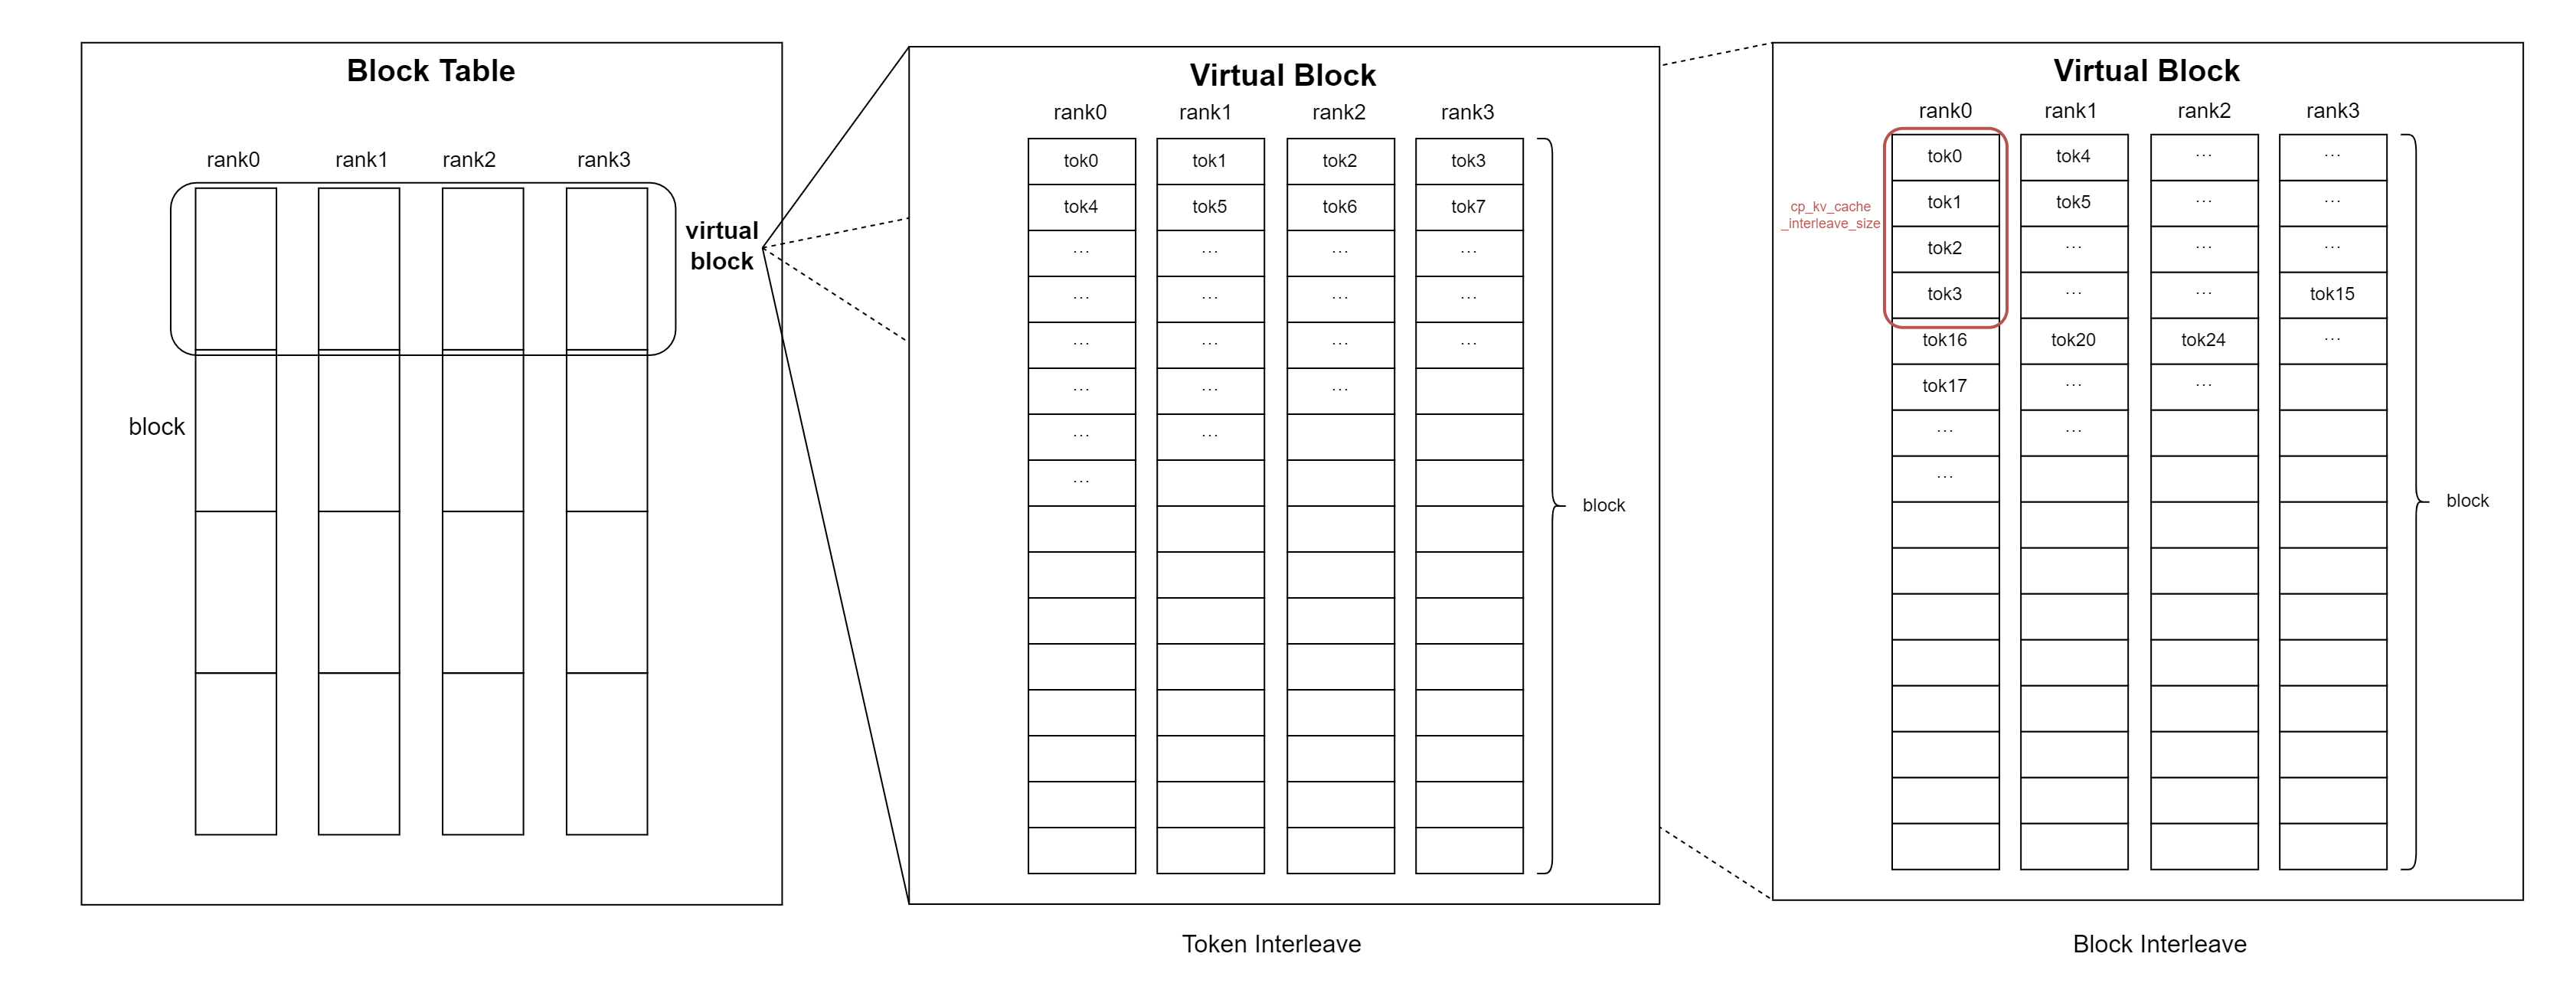
PCP 增加了计算 rank,但不会使虚拟 block 大小成倍增加。当 DCP=1 时,每个 PCP rank 为其 TP 本地的 KV head 保留完整序列。启用 DCP 时,只有某个 token 位置的所有者才会写入其 slot;其他 rank 和 padding 条目会收到 PAD_SLOT_ID(-1),并被排除在 cache 写入之外。
PCP 在注意力计算之前同步 cache 数据或 cache 更新输入。交换点取决于后端。稀疏 indexer 和 compressor 状态有其自己的布局,与 DCP 分片的注意力存储相互独立。
PCP 执行
并行拓扑
在配置了 DP 的部署中,model worker 的数量为 DP * PP * PCP * TP。在一个 DP 副本和 PP stage 内,TP×PCP 网格包含 TP * PCP 个 worker。DCP 复用这些 worker。
对于 TP=2 和 PCP=2:
| PCP 坐标 | TP 坐标 0 | TP 坐标 1 |
|---|---|---|
| 0 | rank 0 | rank 1 |
| 1 | rank 2 | rank 3 |
TP 组沿表的行分布:[0, 1] 和 [2, 3]。PCP 组沿表的列分布:[0, 2] 和 [1, 3]。DCP 可以跨越 PCP 轴或整个网格:
| 配置 | 逻辑 DCP 组 | 组内的 Query head |
|---|---|---|
| DCP=1 | 单 rank 组 | 无序列分片 |
| DCP=PCP=2 | [0, 2]、[1, 3] |
相同的 TP 本地 head |
| DCP=TP*PCP=4 | [0, 2, 1, 3] |
包含不同的 TP head 分区 |
这些列表遵循逻辑 DCP rank 顺序:PCP 坐标先变化,然后是 TP 坐标。
MLA 和 SFA 实现了两种堆叠布局;GQA/MQA 堆叠要求 DCP=PCP。DSA 和 DSA V4.1 PCP 使用复制的 cache,其 DCP 堆叠超出了它们所记录的 PCP 配置范围。当 PCP=1 时,DCP 组位于 TP 内:MLA 要求 TP % DCP == 0,稀疏 SFA 在启用 DCP 时要求 DCP == TP,而 GQA 有额外的 KV head 约束。部署约束列在上下文并行用户指南中。
Batch 生命周期
调度器保留一个全局 batch。上游 PCPManager 将每个 worker step 划分为本地虚拟请求行,并记录如何恢复全局 token 顺序。AscendPCPManager 针对昇腾 buffer、注意力元数据、图 padding 和解码请求分配对这一生命周期进行了适配。
flowchart TD
    A["Global scheduled batch"] --> B["PCP partition"]
    B --> C["Local queries and positions"]
    B --> D["Global request view and restore maps"]
    C --> E["Model layers: cache synchronization and attention"]
    D --> E
    E --> F["Restore global hidden-state order"]
F --> G["Logits and sampling"]预填充:头尾分区
因果注意力使靠后的 query 有更多前置 token 可供关注。PCP 使用头尾分区(也称为 DualChunkSwap)来平衡这一工作。对于 L 个已调度的 query token 和 PCP 大小 P,请求被划分为 2 * P 个 chunk,每个 chunk 最多包含 ceil(L / (2 * P)) 个 token。Rank r 接收 chunk r 和 2 * P - 1 - r。对于 P=4:
Query chunks:  0  1  2  3  4  5  6  7
PCP rank 0:   [0]                  [7]
PCP rank 1:      [1]            [6]
PCP rank 2:         [2]      [5]
PCP rank 3:            [3][4]
每个片段保留其原始位置和已计算的 prefix 长度,因此尾部 query 可以关注较早的 chunk。本地 buffer 会为集合通信进行 padding。较短的请求可能导致仅 PCP 的 rank 没有 query;当拆分会导致某个 chunk 为空时,PCP+DCP 路径会复制较短的预填充。
解码:请求所有权与 cache 分片
当 PCP > 1 且 DCP == 1 时,已调度的解码请求以轮询方式分配给 PCP rank。每个请求的 query(包括固定长度的投机验证)在该 step 内归属于同一个所有者。Cache 更新在 PCP 之间同步,允许所有权在后续 step 中发生变化。没有 query 的 rank 仍参与所需的集合通信。
当 PCP 和 DCP 堆叠时,解码请求会在各个 PCP rank 之间复制。每个 rank 关注其本地的 DCP KV 分片,然后将其部分输出和 softmax 统计量贡献给结果合并。
恢复全局顺序
注意力元数据区分全局请求顺序、本地 query 顺序和收集后的 KV 顺序。AscendPCPAttentionContext 携带全局视图以及连接这些布局的映射。收集到的 hidden state 在 runner 边界处恢复为全局 token 顺序,用于采样和受支持的 draft model 处理。
注意力执行
后端结构
DCP 是作为相应 v1 注意力后端的特化实现,而非其并行副本:
DCPMetadataBuilderMixin负责 DCP 组/rank 发现以及对每个 rank 上下文长度矩阵的访问。DCPImplMixin负责 DCP 集合通信以及通用的部分输出/LSE 合并。- GQA、MLA 和 SFA 的 DCP 构建器继承其 v1 元数据构建器。它们仅添加 DCP 元数据字段,或临时暴露 DCP 专用的缓存视图。
- GQA、MLA 和 SFA 的 DCP 实现继承其 v1 实现,仅重写通信或缓存布局不同的 kernel 阶段。
常规的 v1 构建器仍然是请求分类、padding、掩码、图元数据以及通用 KV 缓存元数据的唯一权威来源。DCP 专用元数据不会纳入常规 v1 元数据 schema。
对于 PCP,AscendPCPAttentionContext 向后端元数据构建器提供全局请求视图和恢复映射。当 PCP 与 DCP 叠加使用时,同样适用本地查询/全局缓存的区分。
预填充和分块预填充
在分块或缓存预填充期间,本地查询必须关注分布在DCP组中的KV缓存分片。
- MLA收集上下文KV缓存,恢复请求连续顺序,并为当前查询块计算注意力。
- GQA在DCP组中收集查询头,针对每个本地KV分片计算注意力,并合并部分输出和LSE值。
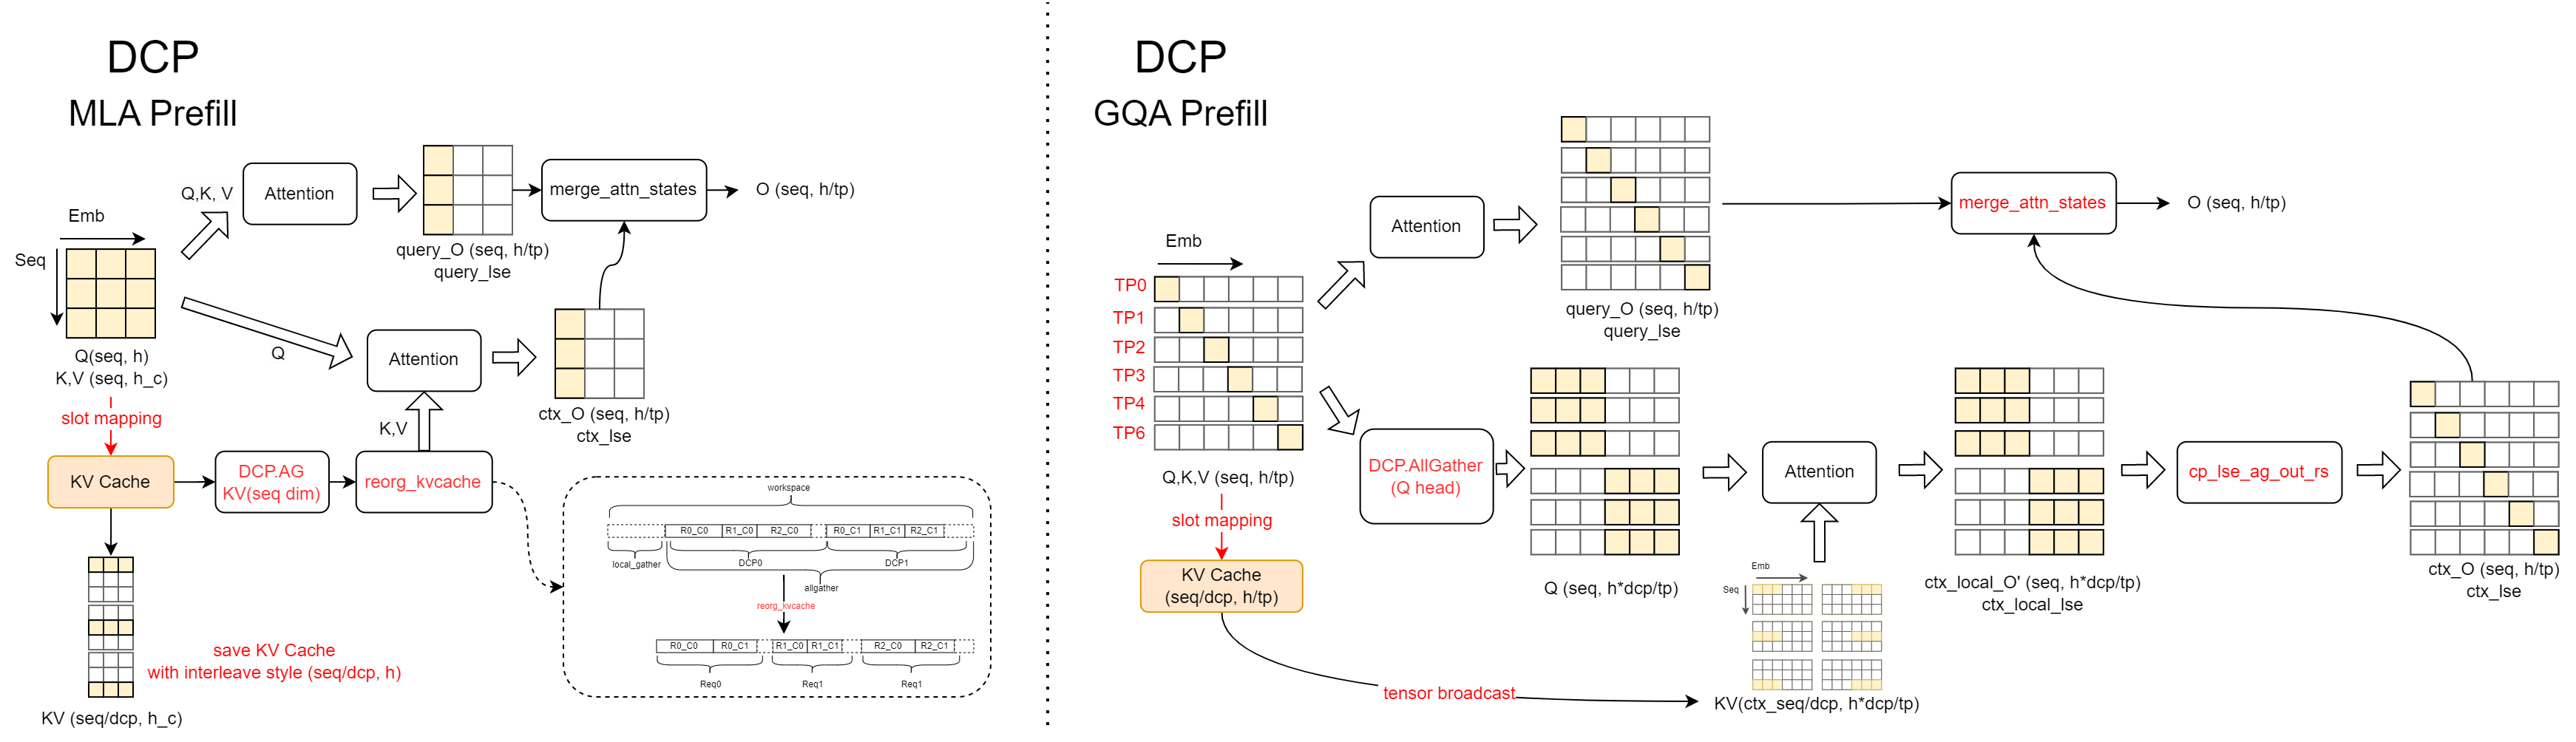
仅使用 PCP 时,GQA 和 MLA 在计算本地查询的同时,收集当前 K/V 或 latent KV 以插入缓存。在 PCP+DCP 下,GQA 将合并后的历史结果映射回本地查询片段,并将其与当前 token 因果前缀上的注意力相结合。MLA 以有界分块方式收集历史 KV;发送方从全局 batch 推导出共享计划,从而使不同的本地片段长度产生匹配的集合通信大小。
解码
解码收集每个DCP rank所需的查询头,针对本地KV缓存分片计算注意力,并在DCP组中合并部分输出和LSE值。
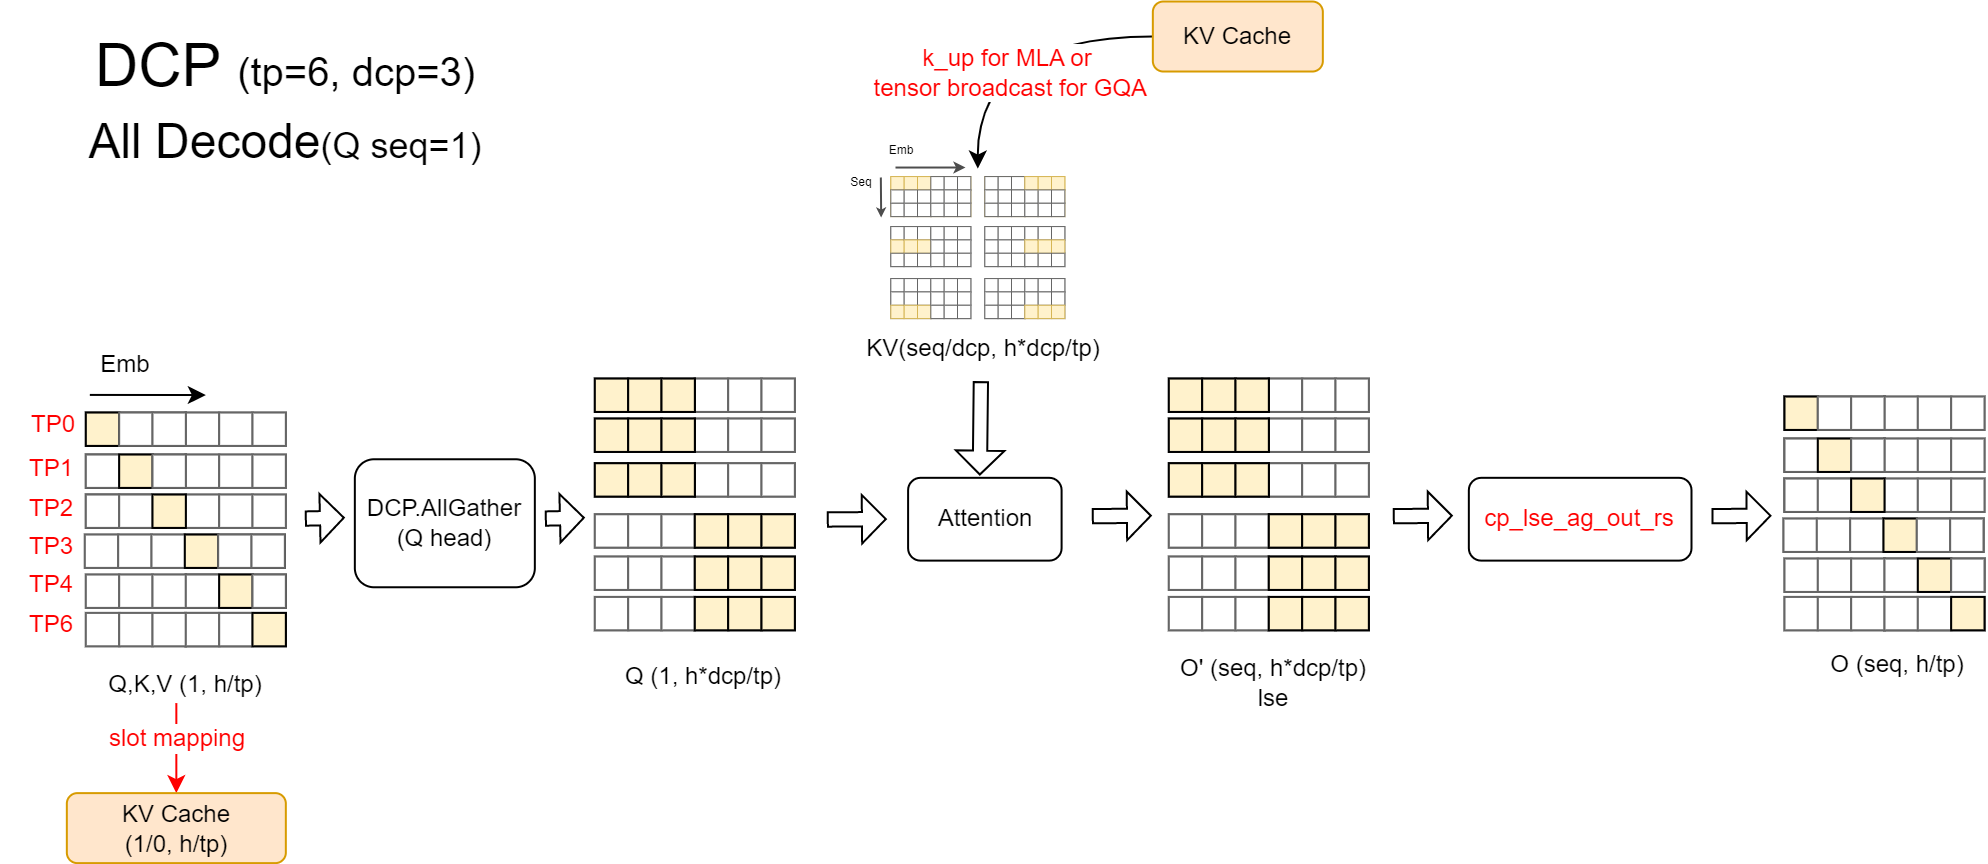
因果多 token 解码可以分别计算历史和当前 token,然后使用 LSE 合并它们的结果。这样既保持了当前 token 的因果性,又使历史保持 DCP 分片。
合并 DCP 结果
对于某个查询/头,分片 j 返回归一化的注意力输出 O_j 和对数和指数 L_j。完整结果使用它们的 softmax 权重:
当 DCP=PCP 时,Q 头在组内已经相同。共享合并路径跨 PCP 收集部分输出/LSE 贡献。当 DCP=TP*PCP 时,不同的 Q 头首先跨 TP 收集;随后输出交换合并 TP 和 PCP 的贡献,并恢复 TP 本地的头范围。仅 TP 的 DCP 在其 DCP 组内交换贡献。通用操作由 DCPImplMixin 和 dcp_a2a_fused 实现。
GLM-5.2 SFA DCP复制索引器
GLM-5.2 使用带有 LightningIndexer 的稀疏 Flash Attention(SFA)。对于 DCP,indexer 需要全序列视图,以选择与非 DCP SFA 相同的稀疏 top-k 块,而大得多的 SFA KV 缓存应保持分片,以保留 DCP 的内存优势:
- The LightningIndexer cache is replicated on every DCP rank, so index selection uses the complete sequence.
- The SFA KV cache remains DCP-local. During decode, global indices from the replicated indexer view are remapped to local KV indices.
- During prefill or a mixed batch, KV blocks referenced by the request block table are compacted and all-gathered after the current layer writes its KV cache.
- Decode-only batches retain the DCP SFA Q-gather and result-merge path.
当启用 DCP(decode_context_parallel_size>1)时,稀疏 SFA 模型会自动选择此模式。
对于 GLM-5.2 DCP 部署,请保持 cp_kv_cache_interleave_size 等于 KV 缓存块大小:
vllm serve <glm-5.2-model> \
  --tensor-parallel-size <N> \
  --prefill-context-parallel-size 1 \
  --decode-context-parallel-size <N> \
  --block-size <B> \
  --cp-kv-cache-interleave-size <B>
复制的 indexer 会使 indexer 缓存内存按 DCP world size 成比例增加;SFA KV 缓存本身保持分片。
在 PCP+DCP 下,紧凑块表计划从全局请求视图推导得出。SFA PCP 同时支持 KV 输入收集和融合 prolog。融合 prolog 首先写入本地缓存行;这些行被打包、收集,并写入接收方缓存。Indexer 更新单独同步。
DSA 与 DSA V4.1 PCP
DSA PCP 收集隐藏状态并恢复全局顺序,以用于缓存更新、压缩和索引。随后注意力计算本地查询行。DSA V4.1 遵循相同的本地查询/全局缓存结构,并带有其滑动窗口和压缩器状态,使用后端专用元数据。
与其他特性的集成
- 权重分片: Embedding 和 LM-head 权重可以跨 TP×PCP 进行分区。支持的 SFA/DSA O-projection 也使用 PCP 权重分片:prefill 可以临时收集权重,而分片 decode 则交换激活值并将投影结果返回给其所有者。有关 embedding、LM-head 和 O-projection 的选项,请参阅 PCP 权重分片配置。
- 图执行: 本地执行大小和全局批次元数据共存。输入、slot 和恢复缓冲区在重放过程中保持稳定的地址,捕获元数据必须描述运行时布局。有关重放机制,请参阅 ACL Graph,有关支持的模式,请参阅 CP 用户指南。
- 投机推理: 目标使用其 PCP 拓扑;支持的 draft 路径在每个 peer 上以逻辑 PCP=1 运行。目标输出会被恢复以用于 draft 处理和采样。Draft DCP 支持仍因模型而异。
- KV 传输: 在文档所述的 PCP P/D 设置中,生产者使用 PCP,消费者使用 PCP=1。对于独立 DCP 和 PCP+DCP,KV 传输要求将
cp_kv_cache_interleave_size显式设置为缓存块大小。
配置和连接器兼容性列在 Context Parallel 用户指南 中。
扩展需要一致的拓扑检查、query/cache 映射以及用于投影和采样的输出布局。复用基础元数据构建器和共享的 DCP 辅助工具。与非 CP attention 进行对比,包括带缓存的/chunked prefill 和不均匀的本地工作;图和 draft 路径需要各自的元数据覆盖。请参阅测试指南。
相关文件
- Slot mapping:
vllm_ascend/worker/block_table.py - Input and attention metadata:
vllm_ascend/worker/v1/model_runner.py - Shared DCP backend capabilities:
vllm_ascend/attention/context_parallel/common_cp.py - GQA DCP backend:
vllm_ascend/attention/context_parallel/attention_cp.py - MLA DCP backend:
vllm_ascend/attention/context_parallel/mla_cp.py - SFA DCP backend:
vllm_ascend/attention/context_parallel/sfa_cp.py - DSA PCP backend:
vllm_ascend/attention/context_parallel/dsa_cp.py - Upstream PCP groups and virtual batches:
vllm/distributed/parallel_state.py,vllm/v1/worker/gpu/pcp_manager.py - PCP batch and metadata:
vllm_ascend/worker/v2/pcp_manager.py,vllm_ascend/worker/v2/attn_utils.py - PCP/DCP slot mapping:
vllm_ascend/worker/v2/block_table.py - Backend selection and configuration:
vllm_ascend/platform.py - DSA V4.1 PCP backend:
vllm_ascend/attention/context_parallel/dsa_v41_cp.py