RFork 指南
本指南说明如何在 vLLM Ascend 中将 RFork 用作模型加载器插件。
概述
RFork 是 vLLM Ascend 的一种热启动权重加载路径。新实例无需始终从存储中读取模型权重,而是可以向外部规划器请求一个兼容的 种子 实例,然后通过 YuanRong TransferEngine 直接从该种子实例拉取权重。
当前实现中的 RFork 加载流程如下:
- 使用
--load-format rfork启动 vLLM。 - RFork 在本地 NPU 上初始化模型结构,准备所需的张量布局,并注册本地权重内存。
- RFork 根据配置指纹、结构摘要和部署拓扑构造 seed key,然后向规划器请求兼容的 seed。
- 如果返回了 seed,RFork 会获取其传输元数据,并通过
YuanRong TransferEngine将权重复制到已注册的本地缓冲区。 - 如果没有返回兼容的 seed,或 RFork 初始化、seed 获取或传输在可重试阶段以 RFork 处理的错误类别(导入、I/O、运行时和取值错误)失败,RFork 会释放已注册内存和 seed 服务,再回退到默认加载器。只有清理成功后才能回退;如果无法释放已注册内存或 seed 服务,RFork 会抛出异常,避免在旧权重仍被固定时分配第二份模型。
- 成功加载的模型可以发布本地 seed 服务,并向规划器发送心跳。发布会等待源 seed 的租约释放。
如果模型加载完成后 seed 服务或其规划器发布失败,推理仍会继续。RFork 会记录失败并保持模型可用,但该实例不会被发布为 seed。
如果 draft 模型的可传输权重已由已加载的 target 模型持有,RFork 会跳过注册、seed 获取和传输,并报告 source=shared_target;参见 MTP draft 权重复用。
Engram 主机表处理和部署级协调请参阅 FAQ。
关键概念
| 术语 | 含义 |
|---|---|
| Seed | 已加载并对外发布 NPU 权重内存、可向兼容接收端提供权重的实例。 |
| 规划器(Planner) | 外部控制面服务,负责匹配 seed 键、分配租约、跟踪心跳,并可选地删除 seed。 |
| Seed 键 | 由兼容性指纹、结构摘要和分片拓扑派生的不透明标识符。它同时充当 seed 元数据服务的凭据。 |
| 兼容性指纹 | 对改变张量内容但不改变形状的配置计算的摘要,例如 RFork 协议版本、模型修订版本、量化配置、架构、RoPE 设置、kv_role 和 mix_placement。 |
| 结构摘要 | 对已构建模型的可传输张量清单计算的摘要:稳定 ID、形状、dtype 和 NPU 格式。 |
| 租约 | 为单个接收端临时分配的 seed 容量,使用后通过 /put_seed 释放。 |
| 加载来源 | 加载摘要中报告的最终结果:transfer、local、fallback 或 shared_target。 |
架构
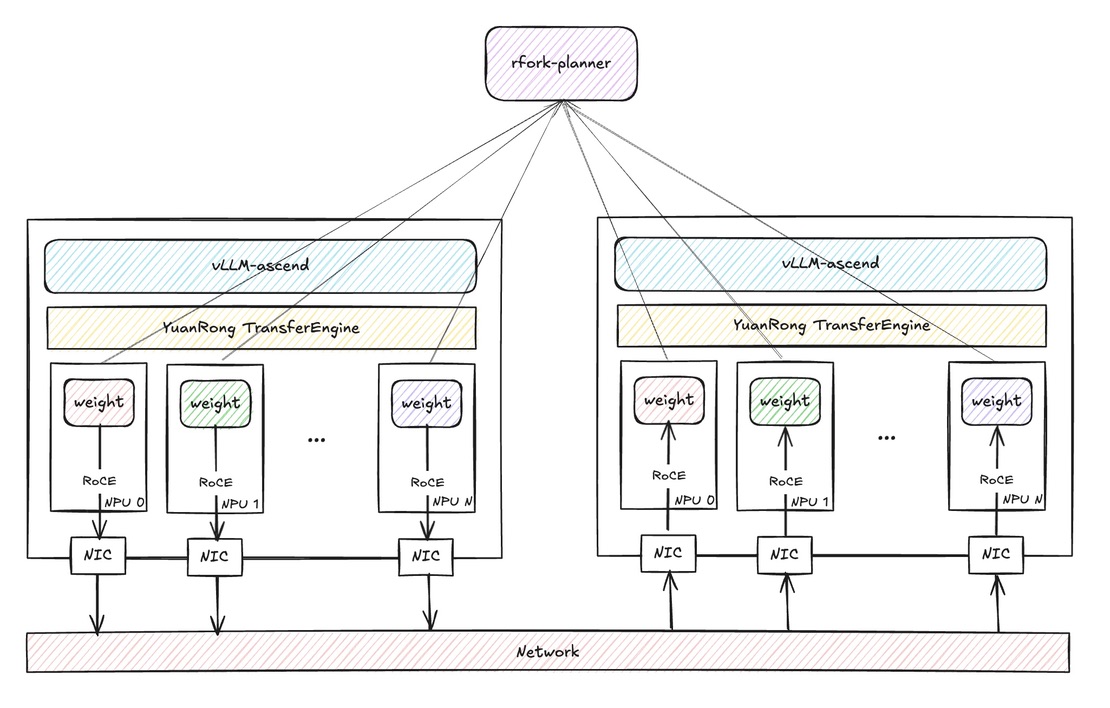
加载流程
flowchart TD
    A["vLLM starts with --load-format rfork"] --> B{"Bypassed by sleep mode, online weight transfer, or EPLB?"}
    B -- Yes --> Z["Default loader; no seed advertised"]
    B -- No --> C["Build model and prepare tensor layout"]
    C --> D{"Draft weights fully owned by the target?"}
    D -- Yes --> E["Reuse target weights; log source=shared_target"]
    D -- No --> F["Register weight memory and bind seed key"]
    F --> G["Request a lease from the planner"]
    G --> H{"Compatible seed returned?"}
    H -- No --> I["Release RFork memory and seed service"]
    H -- Yes --> J["Transfer weights through YuanRong TransferEngine"]
    J --> K{"Transfer succeeded?"}
    K -- No --> I
    K -- Yes --> L["Finalize model; log source=transfer"]
    I --> M{"Cleanup succeeded?"}
    M -- No --> N["Abort startup"]
    M -- Yes --> O["Default loader; log source=fallback or local"]
    L --> P["Publish seed service and heartbeats"]
O --> P应用场景
- 首次成功加载后的横向扩容:第一个实例仍可能从存储加载,但后续具有相同部署标识的实例可以将其作为种子复用,从而缩短启动时间。
- 弹性服务集群:由于 RFork 会向规划器询问可用的种子,因此适用于实例动态创建和回收的集群。
- 拓扑敏感型部署:RFork 从配置指纹、已构建模型可传输张量的结构摘要以及分片拓扑(
tp_rank、可选的pp_rank、可选的ep_rank、可选的sharded_dp_rank,以及可选的draft标记)派生 seed 键,因此只有结构和拓扑兼容的实例才会被匹配在一起。
使用方法
要启用 RFork,请传递 --load-format rfork,并通过 --model-loader-extra-config 中的 JSON 对象或下方回退表中列出的环境变量提供必需设置。
RFork 前提条件
- 在每个 RFork 实例上安装运行时依赖
YuanRong TransferEngine。 - 运行一个实现 RFork seed 协议的规划器服务。一个简单的模拟规划器脚本位于
rfork_planner.py。
配置字段
| 字段名 | 类型 | 描述 | 允许值 / 备注 |
|---|---|---|---|
| model_url | 字符串 | 用于构建 RFork seed 键的逻辑模型标识符。 | RFork 传输必需。需要共享种子的实例必须使用相同的值。非空 JSON 字符串优先于 MODEL_URL;JSON 值缺失、为空或非字符串时,回退到该环境变量。 |
| model_deploy_strategy_name | 字符串 | 与 model_url 一起用于构建 seed 键的部署策略标识符。 |
RFork 传输必需。需要共享种子的实例必须使用相同的值。非空 JSON 字符串优先于 MODEL_DEPLOY_STRATEGY_NAME;JSON 值缺失、为空或非字符串时,回退到该环境变量。 |
| rfork_scheduler_url | 字符串 | 用于种子分配、释放和心跳的规划器服务的基础 URL。 | 基于规划器的匹配必需。示例:http://127.0.0.1:1223。非空 JSON 字符串优先于 RFORK_SCHEDULER_URL;JSON 值缺失、为空或非字符串时,回退到该环境变量。 |
| rfork_seed_timeout_sec | 数字 | 等待本地种子 HTTP 服务在启动后变为健康状态的超时时间;与 rfork_request_timeout_sec 一起,还决定关闭时等待心跳线程停止的时间上限。 |
可选。默认值:5.0。必须是有限且大于 0 的数值;也接受 "7.5" 这样的数字字符串。有效的 JSON 值优先于 RFORK_SEED_TIMEOUT_SEC;JSON 值无效或未提供时,使用有效的环境变量值,否则使用默认值。 |
| rfork_request_timeout_sec | 数字 | 规划器请求和 seed 元数据请求的 HTTP 连接/读取超时时间。 | 可选。默认值:10.0。必须是有限且大于 0 的数值;也接受 "7.5" 这样的数字字符串。启动健康探测使用单独的上限:剩余的 rfork_seed_timeout_sec,且不超过 10 秒。有效的 JSON 值优先于 RFORK_REQUEST_TIMEOUT_SEC;JSON 值无效或未提供时,使用有效的环境变量值,否则使用默认值。 |
| rfork_model_identity_headers | 布尔值 | 为每个规划器请求附加可读的模型身份请求头。 | 可选。默认值:false。显式 JSON true 或 false 会覆盖 RFORK_MODEL_IDENTITY_HEADERS;否则环境变量接受 0、1、true 或 false,忽略大小写和首尾空白。 |
| rfork_heartbeat_interval_sec | 数字 | 规划器心跳上报的间隔时间。 | 可选。默认值:30.0。仅支持 JSON 配置。必须是有限的正数;无效值会导致配置初始化失败。 |
| rfork_lease_release_max_attempts | 整数 | 在瞬时租约释放失败转为较慢的后台间隔重试之前的快速尝试次数。 | 可选。默认值:3。仅支持 JSON 配置。必须是正整数;无效值会导致配置初始化失败。规划器的永久性拒绝仍会停止重试。 |
| rfork_lease_release_retry_interval_sec | 数字 | 快速租约释放重试之间的间隔时间。 | 可选。默认值:30.0。仅支持 JSON 配置。必须是有限的正数;无效值会导致配置初始化失败。 |
| rfork_seed_removal_supported | 布尔值或 null |
规划器是否实现可选的 /remove_seed 和 draining 协议。 |
可选。仅支持 JSON 配置。未提供时默认为 false(跳过删除)。显式 true 要求管理员确认 200 表示已删除、409 表示正在 draining、404 表示 seed 记录不存在。false 跳过删除,null 启用自动检测。自动模式下,只有收到 200 或 409 才确认接口受支持;未知含义的 404 不视为删除成功,405 或 501 表示不支持。 |
| rfork_seed_bind_host | 字符串 | 种子 HTTP 服务使用的本地地址。 | 可选。默认值:0.0.0.0。非空 JSON 字符串优先于 RFORK_SEED_BIND_HOST;JSON 值缺失、为空或非字符串时,回退到该环境变量,再回退到默认值。 |
| rfork_seed_port_base | 整数 | 确定性种子 HTTP 端点的基准端口。 | 可选。默认值:0,表示由操作系统分配端口。仅支持 JSON 配置。基准端口必须是 [0, 65535] 范围内的整数;无效值会导致配置初始化失败。对于非零基准值,主模型和 draft 模型为每个 worker 预留相邻槽位:主模型使用 base + 2 * global_rank,draft 使用 base + 2 * global_rank + 1。如果计算出的端口超过 65535 或已被占用,seed 服务会回退到由操作系统分配。请将此范围与 TransferEngine、其 HIXL 端点范围以及其他服务端口分开。 |
| rfork_seed_advertise_host | 字符串 | 向规划器通告为 SEED_IP、并作为 seed 元数据地址返回给接收端的地址。本字段不配置 TransferEngine 数据面端点。 |
可选。未设置时,通告地址取 VLLM_HOST_IP(若已设置),否则使用 vLLM 的默认路由探测结果;在多网卡主机上该地址可能对端不可达。TransferEngine 在初始化时会独立调用 get_ip(),因此多网卡部署除了设置本字段以保证规划器可达外,还必须通过 VLLM_HOST_IP(或修正默认路由)固定数据面接口。非空 JSON 字符串优先于 RFORK_SEED_ADVERTISE_HOST;JSON 值缺失、为空或非字符串时,回退到该环境变量,再回退到自动检测。 |
RFork 会在启动时校验这些配置。仅支持 JSON 的字段取值非法,或必填值在 JSON 对象和环境变量中
均未提供时,会中止启动而不会回退到默认加载器——除非 RFork 先被约束与限制中列出的某项配置完全旁路;此时默认加载器会在不校验 RFork 配置的情况下运行。对于支持环境变量回退的字段,不可用的 JSON 值
会被跳过,改用环境变量或文档中的默认值(见下文)。运行期失败是否回退取决于异常类别,启用
Engram 时还取决于所在阶段:RFork 处理的类别——导入、I/O、运行时和取值错误——在可重试
的加载阶段会回退;这些类别之外的异常会中止启动;协调且不能安全重试的阶段(模型构建、共享权重
finalize、回退清理和本地加载)发生任何失败都会中止。未知的 model_loader_extra_config 键会被
忽略并给出告警,请检查每个字段的拼写。
环境变量回退
RFork 自行管理其环境变量:这些变量在 RFork 加载器内部读取和校验,不会注册到 vllm_ascend/envs.py,因此不会出现在生成的环境变量页面中。RFork 部署请以本节为准。
当 JSON 配置未提供可用值时,以下字段会回退到对应的环境变量:
| JSON 字段 | 环境变量 |
|---|---|
| model_url | MODEL_URL |
| model_deploy_strategy_name | MODEL_DEPLOY_STRATEGY_NAME |
| rfork_scheduler_url | RFORK_SCHEDULER_URL |
| rfork_seed_timeout_sec | RFORK_SEED_TIMEOUT_SEC |
| rfork_request_timeout_sec | RFORK_REQUEST_TIMEOUT_SEC |
| rfork_model_identity_headers | RFORK_MODEL_IDENTITY_HEADERS |
| rfork_seed_bind_host | RFORK_SEED_BIND_HOST |
| rfork_seed_advertise_host | RFORK_SEED_ADVERTISE_HOST |
解析规则:
- 有效的 JSON 值总是优先:字符串字段取非空字符串,超时字段取有限正数(或数字字符串),
rfork_model_identity_headers取显式的true或false。 - JSON 值缺失或不可用——空字符串、
null、类型错误,或不是有限正数的数字——时会被静默跳过:不会导致配置初始化失败,而是继续读取环境变量。设置为空的环境变量视为未设置,此时应用文档中的默认值(可选字符串字段为0.0.0.0或自动检测,超时字段为内置默认值)。字符串值按原样使用、不做裁剪。纯空白的model_url或model_deploy_strategy_name会被视为已设置并原样进入 seed 键,最终表现为难以解释的 seed 未命中;rfork_scheduler_url、rfork_seed_bind_host或rfork_seed_advertise_host的纯空白值则会在使用 URL、绑定或发布时失败。 rfork_model_identity_headers是例外:仅当 JSON 中未提供该键时才回退到环境变量。JSON 值为其他类型会导致配置初始化失败;环境变量取值不在0、1、true、false之内(包括空值)同样失败,因为无法区分错误取值与有意设置。model_url、model_deploy_strategy_name和rfork_scheduler_url没有默认值。当 JSON 配置和环境变量都未提供非空值时,会以配置错误中止启动,而不会回退到默认加载器。
两种来源都是受支持的配置输入。环境变量方式适用于由平台向每个 worker 环境注入设置、使 vLLM 命令行在实例间保持一致的场景;这些变量名固定于 RFork 兼容性,不会迁移到 VLLM_ASCEND_* 命名空间。使用准则:
- 环境变量在构造 RFork 加载器时读取一次;启动后再修改不会生效。
- 每个部署中,每个字段应只从一种来源取值。优先级按字段逐一判定:有效的 JSON 值会静默覆盖环境变量,不可用的 JSON 值又会静默让位于环境变量,因此混用两种来源难以审计。
model_url和model_deploy_strategy_name在所有需要共享种子的实例上必须保持一致。实例间不一致表现为 seed 未命中并回退到存储加载,而不是报错。
示例命令与占位符
运行前替换
<...>中的部分。
1. 安装 YuanRong Datasystem
验证安装能否导入 RFork 初始化 TransferEngine 所需的类型:
python -c "from yr.datasystem import ErrorCode, MemoryRegistration, TransferEngine; print('YuanRong Datasystem is ready')"
2. 启动规划器
一个简单的规划器实现位于 rfork_planner.py。
示例规划器默认给每个 seed 一个容量点。已有活动租约的 seed 会被视为不可用,且 /get_seed 在没有兼容 seed 和所有 seed 容量耗尽时都会返回 404,因此接收端会报告 source=local。并发横向扩容时,请通过 --default-resource-points <N>(或 RFORK_MOCK_DEFAULT_RESOURCE_POINTS)提高容量。容量耗尽在加载摘要中的表现见故障排查。
示例规划器提供无鉴权的 GET /debug/snapshot 路由,会列出所有已注册的 seed_key,以及按 USER_ID 索引的所有活动租约及其 seed 身份和已分配容量。这些租约 ID 可用于调用 /renew_seed_lease 和 /put_seed,因此任何能访问该路由的对象不仅能获取 key,还能续租或释放活动分配。请仅在可信或隔离的网络段中运行(参见 FAQ)。上面的命令将其绑定到 127.0.0.1 以便本地测试;当其他主机需要访问规划器时,请绑定可信的内部网卡,而不是 0.0.0.0。
3. 启动 vLLM 实例
对同一部署中的第一个实例和后续实例使用相同的 RFork 启动命令。
对于第一个实例,规划器通常还没有兼容的 seed,因此 RFork 会回退到默认加载器。加载完成后,该实例可以发布本地 seed 服务,并向规划器报告自身。
对于后续实例,当规划器分配了兼容的 seed 时,RFork 会尝试传输权重。seed 未命中或传输失败会触发回退,但须满足清理要求,并受下文约束条件限制。
export RFORK_CONFIG='{
  "model_url": "<model_url>",
  "model_deploy_strategy_name": "<deploy_strategy>",
  "rfork_scheduler_url": "http://<planner_ip>:<planner_port>"
}'

vllm serve <model_path> \
  --tensor-parallel-size 1 \
  --served-model-name <served_model_name> \
  --port <port> \
  --load-format rfork \
  --model-loader-extra-config "${RFORK_CONFIG}"
也可以通过环境变量代替 --model-loader-extra-config 提供相同设置;字段的 JSON 值仍优先于其环境变量:
export MODEL_URL=<model_url>
export MODEL_DEPLOY_STRATEGY_NAME=<deploy_strategy>
export RFORK_SCHEDULER_URL=http://<planner_ip>:<planner_port>

vllm serve <model_path> \
  --tensor-parallel-size 1 \
  --served-model-name <served_model_name> \
  --port <port> \
  --load-format rfork
4. 多 rank 横向扩容
RFork 按 worker 派生 seed 键,因此每个 rank 必须使用相同的部署身份和布局设置启动。单节点 TP8 部署示例:
vllm serve <model_path> \
  --tensor-parallel-size 8 \
  --served-model-name <served_model_name> \
  --port <port> \
  --load-format rfork \
  --model-loader-extra-config "${RFORK_CONFIG}"
每个 worker 都有自己的 global_rank。设置非零 rfork_seed_port_base 时,每个 worker 预留两个端口:主模型使用 base + 2 * global_rank,draft 使用 base + 2 * global_rank + 1,因此基准范围必须覆盖 2 * world_size 个槽位。
使用流水线并行、专家并行或数据并行时,每个实例都必须传入相同的 --pipeline-parallel-size 值、相同的 --enable-expert-parallel 设置或相同的 --data-parallel-size 值。此时 seed 键会包含 pp_rank、ep_rank,并在权重确实沿 DP 分片时包含 sharded_dp_rank;不一致会表现为 source=local,而不是启动报错。
在多网卡或多机部署中,需要按节点固定两个平面:设置 rfork_seed_advertise_host(或 VLLM_HOST_IP),使对端能访问 seed HTTP 服务;同时设置 VLLM_HOST_IP,使 TransferEngine 使用预期的数据面网卡。
占位符说明
<model_path>: 传递给vllm serve的模型路径或模型标识符。<served_model_name>: vLLM 暴露的服务名称。<planner_ip>: RFork 规划器的 IP 地址或主机名。<planner_port>: RFork 规划器的监听端口。<model_url>: 用于构建 RFork seed 键的稳定模型标识字符串。<deploy_strategy>: 用于构建 RFork seed 键的稳定部署策略名称。<port>: 正在启动的 vLLM 实例的服务端口。
成功加载会记录 source=transfer、local、fallback 或 shared_target。
成功的 TP0 权重读取还会在 INFO 级别记录传输耗时、字节数、分块数和
吞吐量;其他 TP rank 和每个分块的耗时仍保持在 DEBUG 级别。
每次成功注册、读取前接收端以及最终接收端阶段
都会在每个 rank 的 INFO 级别输出一条有界的 RFork tensor layout summary。该摘要会将所有张量
ID、形状、stride、dtype、NPU 格式、逻辑字节数、存储字节
容量、存储偏移和 NPU 描述符元素数量哈希为固定大小的
语义和物理摘要。它还会报告聚合计数以及至多
三个代表性张量,优先选择存储视图或 NPU
描述符大小与逻辑 numel 不同的张量。将接收端的 peer_session
与种子的 session 匹配。摘要差异是诊断信息,其本身
不会拒绝传输。在 checkpoint 布局传输中,比较
receiver_before_read 与 receiver_after_post_load 以确定
加载后钩子是否重建了布局。处理后的布局传输则输出
receiver_after_transfer_finalize,因为其布局处理发生在
读取之前。该摘要不会复制张量数据,也不证明值相等;
请在 NPU 硬件上单独验证输出准确性。
设置 VLLM_LOGGING_LEVEL=DEBUG 以获取每个 rank 的注册、元数据、传输、
租约释放和发布时序信息。
RFork 如何匹配 seed
RFork 并非仅通过 model_url 匹配实例。本地 seed 键由三个层次派生:
- 基于值语义配置的兼容性指纹,
- 基于已构建模型可传输张量的结构摘要,以及
- 分片拓扑:
tp_rank、可选的pp_rank、可选的ep_rank、条件性的sharded_dp_rank,以及可选的draft标记。
兼容性指纹涵盖那些改变张量内容但不改变张量形状的配置:RFork 协议版本、model_url、model_deploy_strategy_name、解析后的模型版本、checkpoint 量化配置摘要、架构列表、RoPE 设置、生效的 P/D 角色(kv_role)以及 mix_placement。
结构摘要基于传输清单所校验的同一份可传输张量清单计算,包括稳定的张量 ID、形状、dtype 和 NPU 格式。任何改变张量结构的设置都会被自动捕获,包括权重 dtype、TP/PP/EP 分片、NZ 和融合 MC2 布局开关、量化后处理及投机草稿模型拓扑。
分片 rank 用于区分形状相同的分片:tp_rank 选择 TP 切片,pp_rank 选择流水线阶段,ep_rank 选择专家集合(专家权重在各 EP rank 之间形状相同),sharded_dp_rank 选择 DP 位置——但仅当权重内容确实沿 DP 维度分片时才如此。有两种部署形式会打破 DP 复制:细粒度 TP(finegrained_tp_config)将选定模块沿 DP 维度分片,以及 data_parallel_size > 1 的 MoE 模型将专家权重沿 DP×TP 平面分片——无论是否启用专家并行,因为在 EP 关闭时,DP 位置是区分形状相同但内容不同的专家分片的唯一依据。在这些情况下,DP rank 作为分片选择器加入 seed 键;复制的 DP rank 则不设置它,并继续共享同一个种子池。
由于结构摘要仅在模型构建完成且其内存注册之后才存在,seed 键采用惰性计算,并在注册完成后立即与摘要一同记录日志(TP rank 0 上为 INFO,其他为 DEBUG)。因此,种子未命中会留下可调试的痕迹,记录下未能匹配的确切键和摘要。seed 键同时充当 seed 服务的凭据,因此 worker 日志与所有其他能接触到该 key 的路径一样,必须保持在 FAQ 所述的信任边界之内。
这意味着两个实例必须在模型标识、张量结构和部署拓扑上达成一致,规划器才会将它们视为可互换的种子。 最终清单在传输前仍会经过校验,RFork 会回退而不是复制不兼容的张量。
规划器职责
规划器将 seed 键视为不透明的兼容性标识符。RFork 根据模型/配置指纹、可传输张量的结构摘要和分片拓扑生成该键。规划器应:
- 按 seed 键精确匹配,通过心跳跟踪 seed 可用性,并根据规划器配置的策略清理过期的 seed 广告。
- 根据 seed 容量分配租约并接受租约释放。声明
LEASE_TTL_SEC的规划器还可以回收遗留或已过期的租约;没有该响应头的旧版规划器必须自行提供失败释放的运维恢复机制。 - 提供 seed 选择和租约状态的可观测信息,便于运维。
租约释放以异步方式进行。尚未解决的释放会延迟将接收端发布为 seed,但不会阻塞推理。随附的规划器是功能示例,并非生产级规划器。
容量与可用性
- 初始时每个 seed 只允许一个并发接收端;只有在测量 seed 侧推理延迟和网卡吞吐后,才提高容量。示例规划器默认每个 seed 一个容量点。
- 接收端横向扩容时,为同一 seed 键注册多个 seed;规划器应把租约分散到不同 seed,而不是总是选择第一个。
- 保持心跳间隔小于规划器的过期 seed TTL,并让租约 TTL 大于预期传输时间加安全余量。规划器通告
LEASE_TTL_SEC时,应启用租约续租。 - 将规划器视为控制面依赖,而不是数据面依赖:seed 到接收端的传输应独立于规划器可用性,初始发布、租约释放和删除都必须能安全重试。
- 暴露 seed 数量、每个 seed 的容量、租约年龄以及命中/回退率,使容量耗尽在变成
source=local之前就能被发现。 - 示例规划器把 seed 和租约保存在内存中。规划器重启后,seed 会通过心跳重新注册,但进行中的租约将丢失;RFork 把
/put_seed的404视为已释放。生产规划器必须持久化状态,或保证租约释放幂等。
协议端点
规划器控制面和每个 worker 的 seed HTTP 服务实现以下端点。SEED_KEY 携带不透明的 seed 键,SEED_REFCNT 始终发送为 0、不承载调度语义,SEED_RANK 在协议线上是必需字段但不得用于兼容性决策(参见“约束与限制”)。启用 rfork_model_identity_headers 时,MODEL_URL、DEPLOY_STRATEGY 和 IS_DRAFT 会附加到每个规划器请求。
规划器端点:
| 端点 | 方法 | 用途 | 必需的请求头 | 响应 |
|---|---|---|---|---|
/add_seed |
POST | 心跳与 seed 发布。 | SEED_KEY、SEED_IP、SEED_PORT、SEED_RANK、SEED_REFCNT |
200;请求头缺失或非法时返回 400 |
/get_seed |
GET | 请求兼容 seed 的租约。 | SEED_KEY |
200,响应头包含 SEED_IP、SEED_PORT、SEED_RANK、USER_ID 以及可选的 LEASE_TTL_SEC;没有兼容 seed 时返回 404 |
/put_seed |
POST | 使用后释放租约。 | SEED_IP、SEED_PORT、SEED_RANK、USER_ID |
200;租约不存在时返回 404 |
/renew_seed_lease |
POST | 规划器通告 LEASE_TTL_SEC 时续租。 |
SEED_IP、SEED_PORT、SEED_RANK、USER_ID |
200;租约不存在时返回 404 |
/remove_seed |
POST | 撤销 seed 广告(由 rfork_seed_removal_supported 控制的可选扩展)。 |
SEED_KEY、SEED_IP、SEED_PORT、SEED_RANK |
200 已删除;409 正在 draining;404 记录不存在;405 或 501 不支持 |
每个已发布 worker 提供的 seed HTTP 端点:
| 端点 | 方法 | 用途 | 请求 | 响应 |
|---|---|---|---|---|
/health_check_with_key |
GET | 带 key 的存活探测。 | seed_key 查询参数 |
正确 key 返回 200;错误 key 返回 400 |
/get_rfork_transfer_engine_info |
GET | 获取传输元数据(TransferEngine 会话与格式信息)。 | seed_key 查询参数 |
返回 200 及传输元数据;key 错误时返回 404 |
参考规划器还提供 GET /healthz,以及仅用于 mock 调试的、FAQ 中所述的无鉴权 GET /debug/snapshot。
网络可达性
| 路径 | 传输 / 端口 | 方向 | 配置项 |
|---|---|---|---|
| 规划器控制面 | HTTP,rfork_scheduler_url |
worker → planner | rfork_scheduler_url |
| seed 元数据 | HTTP,seed 端口 | 接收端 → seed | rfork_seed_bind_host、rfork_seed_port_base 或 OS 分配、rfork_seed_advertise_host |
| 权重传输 | TransferEngine RPC 与 HIXL | 接收端 ↔ seed | YR_TE_RPC_PORT_MIN/YR_TE_RPC_PORT_MAX、YR_TE_HIXL_BASE_PORT |
| vLLM 服务 | HTTP | 客户端 → 实例 | --port |
规划器不会主动连接 seed 服务,只返回通告的 SEED_IP 和 SEED_PORT。接收端必须能访问 seed HTTP 端口,且 seed 与接收端必须能互相访问对方的 TransferEngine 和 HIXL 端点。
支持的模型
RFork 面向 DeepSeek、Qwen、GLM 等主流模型系列,但兼容性由传输契约决定,而不是模型系列名称。当模型构建出的 NPU 张量清单通过结构摘要、张量 ID、manifest、dtype、NPU 格式、别名关系图和非 NPU 状态检查时,该模型才符合条件。DeepSeek V4.1 Engram CPU 卸载,以及 AscendDeepSeekMTP 和 DeepSeek V4/V4.1 DSpark draft 的检查点准备有模型专用适配。对于其他模型、量化变体或 NPU 格式,请在目标模型和硬件上确认 source=transfer 并与默认加载器对比输出精度,以完成 RFork 验证。
投机解码
启用投机解码时,每个 worker 先加载目标模型,再加载 draft 模型,两者都经过 RFork 加载器。RFork 将 draft 作为独立模型处理:
- Draft 识别。 模型配置的
runner_type="draft",或 Hugging Face 配置的model_type以_mtp结尾、architecture 以MTPModel结尾时,该模型被视为 draft。 - 独立的 seed。 draft 有自己的 RFork session 和 seed 键。seed 键包含
draft标记,因此 draft 不会匹配到目标模型的 seed。rfork_seed_port_base非零时,draft 的 seed 服务使用base + 2 * global_rank + 1。启用 planner 模型身份请求头时,draft 的请求会携带IS_DRAFT: true。 - 与目标模型共享的权重。 注册 draft 前,RFork 会对目标模型已注册的权重块做快照。如果 draft 的每个可传输张量都位于这些块内,draft 报告
source=shared_target,既不传输也不发布(参见draft 模型何时报告shared_target?)。否则 RFork 只注册并传输这些块之外的 draft 张量。 - 依赖检查点的 draft 状态。 很多 draft 会在
load_weights中根据检查点权重名称,决定是否拥有自己的 embedding 和 LM head;之后 proposer 会把 draft 不拥有的部分替换为目标模型的模块。RFork 不执行load_weights,因此会在注册前为AscendDeepSeekMTP和 DeepSeek V4/V4.1 DSpark draft 恢复这部分状态(参见 FAQ 中关于 draft 检查点元数据的条目)。其他 draft(例如 EAGLE/EAGLE3、DFlash、Glm5NextMTP,以及 Qwen3、GLM 或 Kimi K3 DSpark)在 RFork 下保持构造时的默认值,可能导致 proposer 使用错误的 embedding 或 LM head。 - 加载后被改写的权重。 目标模型采用 QuaRot 量化时,Qwen3、GLM、Kimi K3 DSpark draft 以及 DFlash2 draft 会在
post_process中原地旋转一个 draft 投影权重;此时加载器已经返回,draft 的 seed 可能已经发布。接收端可能复制到 seed 已经旋转过的权重,随后自身的post_process会再旋转一次。RFork 不会自动绕过这些配置。 - 验证 draft。 draft 状态错误通常会降低 draft 接受率,而不是改变输出,因为目标模型仍会验证每个 draft token。使用 RFork 验证 draft 时,除了检查
source=transfer和输出精度,还要与默认加载器对比接受率。
性能注意事项
RFork 为张量地址范围建立索引以查找底层分配,并在注册期间使用二分查找检查内存覆盖情况。注册仍会增加 seed 的启动开销,因此 RFork 更适用于后续副本复用 seed,而非单次冷启动。
对于处理后布局的传输,RFork 复用完整的注册张量清单计算初始结构摘要,并复用模型进入 eval 模式后的最终布局摘要立即发布 seed。延迟发布时会再次扫描当前模型;结构不匹配时禁止发布。检查点布局在后处理后重新注册内存并更新传输清单,但保留首次绑定的摘要和 seed 键,不进行发布时的摘要检查。这使兼容的后处理 reshape 能够保留接收端原始查询身份。传输前仍会按照 seed 清单校验张量名称、元素数量、dtype 和 NPU 格式。
性能取决于模型大小、分片拓扑、NPU 张量布局、TransferEngine 注册时间、网络带宽和并发目标端数量。可使用以下指标与默认加载器进行比较:
- 从进程启动到服务就绪的耗时。
- DEBUG 级别
RFork transfer stages日志中的注册、元数据和读取耗时,以及RFork weight transfer completed中的传输字节数和吞吐量(TP rank 0 为 INFO,其他 rank 为 DEBUG)。 - 传输期间 seed 的推理延迟以及存储/主机内存流量。
- seed 命中率、传输失败率和回退率。
约束与限制
- RFork 运行时需要
YuanRong TransferEngine。如果缺少该软件包,RFork 无法初始化传输后端。 - 被发布为 RFork seed 的 worker 会绑定一个 seed HTTP 监听端口。默认
rfork_seed_port_base=0时由操作系统分配端口。设置非零基端口时,每个 worker 会为主模型和 draft 模型预留相邻槽位;如果端口已被占用,或计算出的端口超过65535,则回退到操作系统分配的端口。seed HTTP 端口应与 vLLM 服务端口、TransferEngine RPC 端口和 HIXL 端点范围分开。RFork 仅在 Linux 上受支持,端口冲突回退遵循 LinuxEADDRINUSE语义。 - 在以下任一配置下,RFork 传输都会被完全旁路:模型通过默认加载器加载,也不会发布 seed。RFork 会注册正在使用的 NPU 权重内存并为其他实例提供服务,因此当这部分内存之后可能被释放或改写,或专家放置在加载时无法固定时,不能使用 RFork。旁路判断发生在创建 session 或 TransferEngine 之前,日志为
RFork transfer is disabled when <reason> is enabled; using the default model loader.- 睡眠模式(模型配置或
vllm_config.model_config中的enable_sleep_mode),因为睡眠会丢弃并重新分配权重存储。 - 在线权重传输(设置了
weight_transfer_config),因为权重可能在加载后被替换。 - 静态专家放置(设置了
eplb_config.expert_map_path),因为该放置映射的作用范围在传输张量集合之外。 - 动态 EPLB,因为专家权重和放置位置可能在 seed 服务启动后发生变化。这包括
parallel_config.enable_eplb、eplb_config.dynamic_eplb和eplb_config.expert_map_record_path。
- 睡眠模式(模型配置或
- 回退到默认加载器前,必须先释放 RFork seed 服务和已注册的内存。RFork 最多执行两次清理尝试(
FALLBACK_CLEANUP_MAX_ATTEMPTS,当前为 2),两次尝试之间会短暂退避,然后才回收内存并重新运行默认加载器。对于尚未发布 seed 的接收端,待处理的旧版/put_seed不会阻止原生 finalize;但如果必要的本地清理仍然失败,张量所有者仍被保留,RFork 会抛出异常,拒绝在旧权重仍被固定时分配第二份模型;已经进入 finalized 状态的 session 也会抛出异常。这两种情况都会中止启动,而不会降级为较慢的加载。 rfork_planner.py只是一个简单的模拟实现。如果需要更强的调度、容量管理或生产级可用性行为,请根据 RFork seed 协议实现自己的规划器。其无鉴权的GET /debug/snapshot端点会列出所有已注册的seed_key和所有活动租约的USER_ID;这些 ID 可用于续租和释放租约,因此任何能访问该 mock planner 的对象都能获取集群 key 并干扰活动分配。请确保它仅在可信网络段内可达(详见 FAQ)。- 规划器协议头
SEED_REFCNT和SEED_RANK不承载调度语义,但目前在协议线上都不是可选字段:- 发布 seed 时
SEED_REFCNT始终发送为0,不会用于容量决策(seed 容量由规划器配置控制)。规划器仍必须接受此请求头。 SEED_RANK仍是必需字段。如果/get_seed响应缺少该字段或其值为负数,RFork 会拒绝该响应;在发布 seed、续租、释放租约和删除 seed 的请求中都会发送该字段。规划器必须在/get_seed响应中原样返回,并在其他路由中接受它。已弃用的是将其用于兼容性决策:它重复了 seed key 中已经编码的tp_rank,因此规划器应仅按 seed key 匹配,并将SEED_RANK视为 seed 身份元组中的不透明字段。
- 发布 seed 时
- 每次心跳只检查 seed 服务线程是否仍在运行,不会在每个间隔发送带 key 的 HTTP 健康探测。带 key 的
/health_check_with_key请求仅在服务启动期间发送,因此线程仍存活但 HTTP 监听无响应时,心跳仍可能成功。若需要区分这两种情况,请在网络层面监控已发布的 seed 端口。如果线程退出,RFork 会停止发送心跳,并在规划器支持删除时尝试撤销该 seed 广告。单次心跳故障本身不会停止元数据服务;该服务由关闭或回退清理流程处理。如果删除不受支持或状态未知,RFork 会保留已发布 seed 的已注册内存和存储所有者,直到之后确认撤销且原生清理成功,或进程退出,同时保持已加载模型可继续推理。 - 临时的规划器故障不会停止推理。可重试的初始发布和租约释放会在后台继续。受支持的删除只会在有界重试或后续清理中重试;其他删除失败会保留 HTTP 服务和已注册内存,以便重试。永久性的规划器拒绝则会阻止 seed 晋升。故障日志仅记录首次失败、周期性摘要和恢复事件。
- 对于新支持的 NPU 格式,应在目标 NPU 和模型组合上验证传输准确性及逻辑负载契约;CPU 测试无法证明 NPU 存储的正确性。新增格式时必须进行这项验证,但这不表示运行时需要复制张量声明负载之外的分配器或描述符填充。
升级与滚动重启
seed 复用要求兼容性指纹、结构摘要和分片拓扑完全一致。发生以下任一变更后,已有 seed 将不再匹配新接收端,新实例会从存储加载,直到发布新一代 seed:
- vLLM Ascend 或 vLLM 升级改变了 RFork 协议版本或构建出的张量布局。
- 模型修订版本、检查点或量化配置发生变化。
- 架构、RoPE、
kv_role、mix_placement或布局开关(如 NZ、融合 MC2)发生变化。 - TP/PP/EP/DP 拓扑或细粒度 TP 配置发生变化。
滚动重启期间,新旧实例混跑时应预期出现 source=local 而不是传输。复用相同的 model_url 和 model_deploy_strategy_name 之前,请先停止或 drain 旧 seed;让第一个升级后的实例从存储加载并发布新 seed,再启动其余接收端。请考虑规划器的过期 seed TTL,确保旧广告在容量被复用前过期。
如果要在不升级的情况下开启新的 seed 池,请修改 model_deploy_strategy_name,使新旧 seed 无法互相匹配。
故障排查
- 启动时因 RFork 配置错误而中止。 必需字段在 JSON 对象和环境变量中均未提供,或仅支持 JSON 的字段取值非法。检查每个字段的拼写——未知键只会告警——并重新阅读“环境变量回退”中的解析规则。
- 启动在 RFork 初始化或传输阶段中止。 失败不属于可回退的错误类别,或发生在无法重试的阶段。日志中的异常会指出失败的步骤;修复后重启 worker。
- 加载摘要显示
source=local。 未获得可用租约:没有兼容的 seed、所有 seed 容量耗尽,或规划器请求/响应未通过校验。将记录的seed_key与structural_digest与 seed 实例的值进行对比,并检查规划器的租约与容量状态。除非提高--default-resource-points,示例规划器每个 seed 只允许一个并发租约。分配后被拒绝的租约仍会保留以便释放,因此规划器中可能短暂出现本次尝试的分配记录。 - 加载摘要显示
source=fallback。 RFork 在可重试阶段以可处理的错误失败并回退到默认加载器。这不意味着一定获得过租约:注册先于任何 seed 租约初始化 TransferEngine。检查RFork transfer failedWARNING 及其相邻的规划器警告。 - 加载摘要显示
source=shared_target。 draft 模型复用了 target 模型已持有的权重。没有发生规划器请求或传输;当所有 draft 张量都共享时这是预期行为,不属于回退。 - 所有实例都报告
source=local。 通常是实例间 seed 键不一致:模型修订版本或量化配置不同、model_url或model_deploy_strategy_name取值不同,或分片与布局设置不同。对比各实例的身份日志(RFork ... seed identity bound)。如果键一致,请检查规划器是否已耗尽每个 seed 的容量。 - 指纹相同但结构摘要不同。 张量清单存在差异。检查权重 dtype、NZ 或融合 MC2 布局开关、TP/PP/EP 分片以及量化后处理;使用
RFork tensor layout summary定位差异张量。 - 规划器心跳或发布失败。 临时规划器故障不会停止推理;重试在后台继续,日志仅记录首次失败、周期性摘要和恢复事件。检查
rfork_scheduler_url可达性和rfork_request_timeout_sec。 - TransferEngine 导入或初始化错误。 运行上面的导入检查。缺少软件包属于可处理的错误类别:RFork 会回退到默认加载器而不是进行传输。
- seed HTTP 端口冲突。 非零
rfork_seed_port_base对应的槽位被占用时会回退到操作系统分配;请将基准范围与服务端口、TransferEngine RPC 端口和 HIXL 端点范围分开。 - 启用 Engram 时启动挂起。 协调阶段会中止而不是分裂该组,因此挂起通常指向这些阶段之外的集合通信或外部依赖(如存储或规划器)。收集每个 rank 的堆栈并检查分布式超时。
常见问题
Engram 在 RFork 中如何工作?
启用 Engram CPU 卸载时,RFork 在从本地检查点加载已卸载的 DeepSeek V4.1 Engram 表时传输 NPU 权重。因此,每个接收端都需要匹配的已建立索引的 safetensors 检查点,即使已有 seed,也必须包含 Engram 权重和 scale。RFork 复用 Engram 分片读取器,并通过现有的共享写入同步机制支持 dp_shared_memory=true。主机表和进程本地 UVA 指针不会被传输。
协调范围: 只要设置了
engram_config——无论是否启用 CPU 卸载——由部署级协调器包裹的加载阶段会通过部署 world 的 CPU group 运行:会话建立、模型构建、模型状态准备、主机权重加载、共享权重检查、传输布局准备、权重传输、传输后模型 finalize、回退清理和本地模型加载。在这些阶段中,任一 rank 上出现可回退的失败(例如 seed 未命中、注册失败或传输失败)时,所有 rank 都会改为本地加载;而在被包裹且无法安全重试的阶段(如模型构建、共享权重 finalize、回退清理和本地加载)出错时,所有 rank 都会中止,而不是把该组分裂。旁路选择和 processed-layout 判定在协调器创建之前完成,因此不属于此协调范围。该协调机制目前没有专门的分布式测试覆盖;在生产中依赖它之前,请在目标硬件上验证组内回退行为。
以下主机表规则仅适用于 Engram CPU 卸载。目标端注册或复用共享权重之前,主机表必须完成加载。对于受支持的 DeepSeek 表实现,RFork 会记录完成 状态,并在将其主机张量从非 NPU 状态检查中豁免前,校验张量身份、存储地址和检查点绑定关系。仍保留在 CPU 上的其他已注册参数和缓冲区仍会被拒绝。默认加载器成功返回后,RFork 会记录相同状态,使本地加载 的实例能够将其 NPU 权重发布为 seed。模型实现及其默认加载路径无需添加 RFork 钩子。
seed 未命中或传输失败可能触发上述协调后的默认加载器回退,并再次读取 Engram 表。在构造回退模型前会 显式释放已丢弃的主机表;清理失败会停止加载,而不是分配第二份副本。RFork 只加速 NPU 部分,不会消除 主机表的磁盘 I/O。请让本地检查点和 seed 使用相同的模型修订版本,并为不同检查点使用不同的模型标识。
如果启用 Engram CPU 卸载的模型构造在返回完整模型前失败,RFork 会停止,而不是通过默认加载器重试。无法通过模型安全释放部分构造的主机表;请修复初始化错误并重启 worker。
如何启用规划器模型身份请求头?
在 --model-loader-extra-config 中设置 "rfork_model_identity_headers": true,或在 vLLM worker 环境中设置 RFORK_MODEL_IDENTITY_HEADERS=1。显式的 JSON true 或 false 会覆盖环境变量;其他 JSON 类型或其他环境变量值会导致配置初始化失败。启用后,RFork 会在每个规划器请求中附加 MODEL_URL、DEPLOY_STRATEGY 和 IS_DRAFT 请求头,且 model_url/model_deploy_strategy_name 必须仅包含 ASCII 字符。请求头以明文发送,请避免在模型 URL 中包含凭据。
如何保障 seed HTTP 服务的安全?
该服务本身不做安全保障。seed HTTP 服务是一道信任边界:seed_key 即凭据,任何拿到它的人都能获取传输元数据(张量地址与 TransferEngine 会话),并通过 TransferEngine 读取该实例的 NPU 权重内存。请求为明文 HTTP,无鉴权、无速率限制,因此 RFork 必须部署在可信或隔离的网络段。rfork_seed_bind_host 默认是 0.0.0.0;仅当所有可达网卡都在信任边界内时才保留该默认值,多网卡主机应绑定内部接口。
RFork 自身并未把该 key 当作密钥保管,因此该网络段必须覆盖所有能接触到它的环节:
- worker 日志。 绑定 seed 身份时会完整记录 key(TP rank 0 为 INFO,其他 rank 为 DEBUG),心跳、发布以及 seed 服务失败与恢复的日志消息中也会再次出现(INFO、WARNING 或 ERROR,包括规划器拒绝时嵌入 key 的撤销原因)。日志收集与存储应视为信任边界的一部分。
- HTTP 中间设备。 seed 元数据和健康检查请求将 key 作为 URL 查询参数发送,明文 HTTP 路径上的代理和访问日志都能看到它。
- 规划器。 seed 广告以及
/get_seed、/remove_seed请求通过SEED_KEY请求头携带 key,规划器及任何能观测这些流量的对象都持有其服务的全部 key;租约续租和释放请求则通过 seed 地址、rank 和 user ID 标识租约。随附的示例规划器在GET /debug/snapshot上无鉴权地暴露所有已注册 key 和活动租约的USER_ID;由于这些 ID 可用于续租和释放租约,请勿让信任段之外的对象访问该路由。
错误 key 的元数据请求返回 404,但有效/无效本身仍是可观测的。若 key 到达上述边界之外的任何环节,请更换 model_deploy_strategy_name。
可以使用旧版规划器吗?
可以。RFork 将原始 seed 协议保留为必需基线:POST /add_seed、GET /get_seed 和 POST /put_seed。SEED_KEY 是不透明值,必须按完整字符串匹配;SEED_RANK 仍是 /get_seed 响应以及对应 seed 和租约请求中的必需字段。SEED_REFCNT 始终发送为 0,不承载调度语义,但规划器仍必须接受该请求头。
LEASE_TTL_SEC 是可选的响应头。缺少该响应头时,RFork 接受租约,不启动 /renew_seed_lease,也不设置本地过期计时器,但仍会在成功或失败使用后发送 /put_seed(包括传输校验失败时)。心跳用于报告 seed 存活状态,不会续租接收租约。存在但无效的 TTL 属于协议错误。存在该响应头时,RFork 按 TTL 的三分之一续租,间隔限制在 0.1–30 秒;续租失败会按该间隔重试,且不会停止推理,但租约仍可能在规划器侧过期。失败的旧版 /put_seed 会作为待处理记录保留,但不会阻止原生 finalize;关闭时会尽力执行一次释放,除非已有释放请求在途。
Seed 删除和 draining 是可选的控制面扩展,由 rfork_seed_removal_supported 控制。具体结果取决于规划器响应。确认删除(200、409,或确认记录不存在的 404)会停止心跳和元数据服务。当删除不受支持(405/501,或默认的 false 设置)或未确认(含义不明的 404)时,RFork 会停止心跳并尝试停止元数据服务,但会保留已发布 seed 的已注册内存,直到清理成功或进程退出。永久性拒绝会保留元数据服务和已注册内存,以便之后重试;超时、408/429 和 5xx 则会重试。
量化和 NZ 模型传输哪些内容?
RFork 传输 Ascend 权重后处理后的活跃 NPU 张量,而不是原始检查点参数。接收端构建与 seed 相同的加载后张量布局,RFork 复制推理使用的活跃 NPU 张量。这涵盖权重转置、NZ 转换、打包权重、派生 scale 张量以及 MLA/SFA 运行时张量(如 W_UV 和 W_UK_T)。后处理期间释放的空张量不会包含在传输清单中。
当昇腾配置设置了 weight_nz_mode=2,或硬件权重布局策略为 FORCE_NZ 时,处理后布局路径也适用于非量化模型;其他非量化配置使用检查点布局传输。验证时,seed 和接收端应使用相同的 vLLM Ascend 代码、兼容的 vLLM 版本、相同的模型修订版本和量化配置,以及匹配的分片和布局设置,然后确认 source=transfer 并在 NPU 硬件上对比输出精度。张量布局摘要有助于诊断结构差异,但不能证明张量取值相等。
如何区分 seed 未命中与传输失败?
未获得可用租约的 seed 获取(可能是没有兼容 seed、所有 seed 容量耗尽,也可能是规划器请求或响应校验失败)会记录 seed acquisition was unsuccessful; loading locally(summary rank 为 INFO,其他 rank 为 DEBUG),并报告 source=local。RFork 初始化或传输期间的失败(例如注册、元数据或权重读取错误)会在 WARNING 级别记录 RFork transfer failed,并报告 source=fallback。可结合规划器警告区分两者。复用 target 所持权重的 draft 模型则会改为报告 source=shared_target,不会联系规划器。如果响应在已创建分配之后才校验失败,RFork 会保留该分配以便释放,但仍报告 source=local。
为什么 seed 与接收端的张量 ID 不同?
张量 ID 是可读的规范路径,例如 layers.0.self_attn.impl.scales["w"]。已注册的参数和缓冲区会先通过模块注册边命名,因此即使实现对象暴露了更短的别名,它们的模块路径仍是规范名称。其余张量取经过受支持张量属性的最短路径;长度相同时取路径字典序最小者。容器键使用带类型的标签(字符串加引号,整数、浮点数、布尔值、None、dtype 及由它们组成的元组带类型标记;普通 Enum 成员使用其规范成员名(别名共享该名称),Flag 和 IntFlag 成员使用其整数值),其他类型的键,以及同一容器中标签相同的不同条目,都会直接报错而不是猜测标签。ID 不包含内存地址,也不受属性插入顺序影响。同一张量范围的完全相同别名会被去重,不同存储视图仍保留为独立条目。seed 和接收端必须具有兼容的张量及别名关系图。
RFork 会复制张量载荷之外的填充吗?
不会。RFork 有意为每个张量条目精确读取 numel * element_size 字节,包括处理后的 NZ、打包权重和派生 scale 张量。分配容量、张量稠密逻辑范围之外的仅描述符填充,以及相邻或共享存储,都不属于该张量的载荷,不会被隐式复制。未来若出现需要该范围之外字节的 NPU 格式,需要显式的 manifest 和传输协议支持。对于稠密转置与 reshape,RFork 传输非重叠稠密张量覆盖的一个连续字节范围,不要求单独的 stride 相等性检查;带间隙或重叠的布局仍会被拒绝。
无法读取 draft 检查点元数据时会怎样?
对于采用 AscendDeepSeekMTP 实现的 MTP draft 和 DeepSeek V4/V4.1 DSpark draft,RFork 会在注册张量前准备依赖检查点的状态:AscendDeepSeekMTP 准备 head 所有权和模块别名,DSpark 准备 embedding 和 head 所有权。它会按照默认加载器的 source、revision 和文件选择规则,读取所选 safetensors 头部中的名称。准备过程中可能下载未缓存的远程检查点。如果无法读取元数据(包括以 PT/bin 格式选择的检查点),RFork 会使用默认加载器,并不会将该模型发布为 seed。此适配保留在 RFork 加载器内:对 AscendDeepSeekMTP,复用模型的 head 所有权辅助函数;对 DSpark,复用模型的检查点名称映射,以及其 load_weights 中 embedding/head 的命名规则。目前仅覆盖这些 draft。其他 draft 实现(例如 Glm5NextMTP 和其他 DSpark draft)同样从检查点权重推导 head 所有权,而 RFork 在注册前不会执行它们正常的 load_weights;在依赖 draft 权重复用前,请在目标模型和硬件上验证 source=transfer 及输出精度。
draft 模型何时报告 shared_target?
当 draft 模型在其 target 模型之后加载时,RFork 会检查每个可传输的 draft 张量是否都已落在 target 注册的权重块内。如果所有 draft 权重都共享、没有独立的 draft 权重,且不存在非 NPU 状态,RFork 会跳过目标端注册、seed 获取和 TransferEngine 复制。它还会跳过加载后处理,因为重新处理可能改写 target 持有的存储;随后完成模型 finalize 并记录 source=shared_target。此路径不会联系规划器,也不会将 draft 作为独立 seed 发布。
如果任一 draft 张量独立,或存在任何非 NPU 状态,RFork 会改为走正常的 transfer、local 或 fallback 路径。启用 Engram 时,每个部署 rank 必须得出一致结论;结论分裂会中止启动,而不是混用共享与传输的 draft 权重。
如何配置 TransferEngine 端口?
YuanRong TransferEngine 的 RPC 端口不是配置字段:RFork 以端口 0 初始化该引擎,引擎会绑定并持有一个由操作系统分配的端口,RFork 通过 get_rpc_port() 读回该端口,并将其发布为传输会话端点。端点主机由 vLLM 的 get_ip() 独立选择,该函数会遵循 VLLM_HOST_IP;rfork_seed_advertise_host 只会改变规划器广告。若要将引擎限制在固定的端口范围内(例如用于防火墙规则),请设置 YuanRong 的 YR_TE_RPC_PORT_MIN 和 YR_TE_RPC_PORT_MAX 环境变量(两者均为必需,有效范围在 1024-65535 内且不处于临时端口范围 32768-60999);无效值会回退到由操作系统分配。请将此端口范围与种子 HTTP 端口和 HIXL 端点范围分开。HIXL 数据平面端点默认使用基准端口 22000(YR_TE_HIXL_BASE_PORT,每个物理设备 100 个端口),在同时部署两种引擎的节点上,该范围与 Mooncake ADXL 默认基于 20000 的段保持错开。